Anthropic v pondelok večer vydal Claude Fable 5.2 a Claude Mythos 5.2, nové modely na najnáročnejšie technické úlohy. Nezávislá firma Artificial Analysis ho hneď postavila na prvé miesto svojho rebríčka inteligencie, Anthropic zároveň zlacnil API o 20% a model je dostupný na všetkých platených plánoch. Pozreli sme sa, čo benchmarky naozaj merajú, čo hovoria nezávislí testeri, na čo ho ľudia už používajú a koľko vás to bude stáť.
Mimochodom k téme som urobil aj špeciálne video na Youtube, ktoré si môžete pozrieť tu:
Fable a Mythos: jeden model, dve verzie
Fable 5.2 a Mythos 5.2 sú v skutočnosti ten istý model. Rozdiel je v ochranách. Fable má silné poistky v kyberbezpečnosti a biológii, preto ho môže používať ktokoľvek s plateným plánom. Mythos tieto poistky nemá a dostanú ho len overené organizácie, ktoré pracujú na obrane systémov alebo na biomedicínskom výskume. Ide o nástupcov modelov Fable 5.1 a Mythos 5.1 zo septembra.
Zaujímavé je, že Anthropic sám neodporúča Fable na všetko. Na väčšinu programovania a kancelárskej práce radí začať s modelom Claude Opus 5.5, ktorý nazýva najsilnejším modelom na každodennú prácu, a k Fable siahnuť až pri najambicióznejších a otvorených úlohách.
Fable and Mythos are best for the most ambitious, open-ended technical work.
— Claude (@claudeai) November 9, 2026
For most coding and knowledge tasks, we recommend starting with Opus 5.5, our strongest daily driver, then moving to a different model depending on the scope and complexity of your work.
Benchmarky vysvetlené po ľudsky
Čísla z tabuliek bez kontextu veľa nepovedia, preto pri každom teste uvádzame, čo vlastne meria.
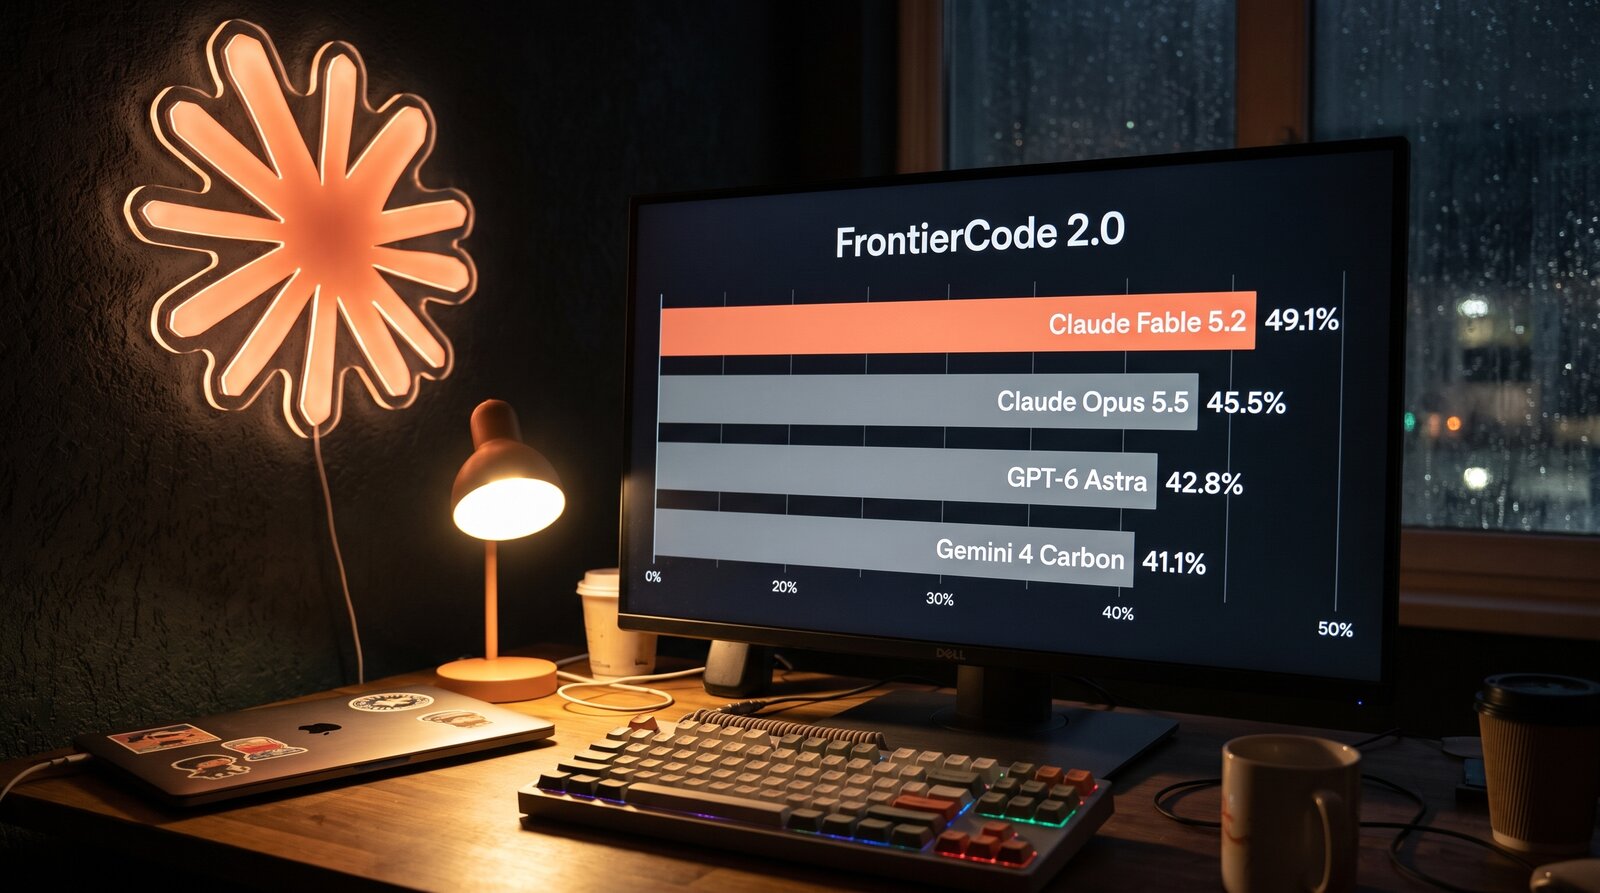
FrontierCode 2.0 (49,1 %) meria, koľko percent navrhnutých zmien v kóde by správcovia skutočných open source projektov prijali. Fable 5.2 je tu najlepší zo všetkých vydaných modelov, Opus 5.5 má 45,5 %, GPT-6 Astra 42,8 %, Gemini 4 Carbon 41,1 % a predchodca Fable 5.1 len 32,4 %. Pri nastavení High dosiahol Fable podľa Anthropicu zhruba úroveň Opusu na maxime, a to za približne polovičnú cenu za úlohu.
FrontierSWE v2 (69,9 %) testuje bežné softvérové inžinierstvo, teda opravy chýb a nové funkcie v reálnych projektoch. OSWorld 2.1 (89,3 %) meria, ako dobre AI sama ovláda počítač: kliká, vypĺňa formuláre a pracuje v aplikáciách. Humanity’s Last Exam (74,2 % s nástrojmi) je zbierka mimoriadne ťažkých otázok z desiatok odborov, Opus 5.5 tu má 67,7 %. Terminal-Bench-Science (74,6 %) skúša vedecké úlohy riešené v príkazovom riadku.
Najväčšie skoky sú tam, kde ide o prácu podobnú ľudskej. V teste Remote Labor Index, ktorý obsahuje skutočné zákazky od freelancerov, dosiahol 41,3 % oproti 21,3 % pri Opuse 5.5. V simulácii RoboDojo, kde model ovláda dvojramenného robota, má 64,9 % oproti 39,4 % pri Opuse. Fable však nevyhráva všade. V teste AutomationBench, ktorý meria automatizáciu bežných firemných procesov, ho s 53,9 % predbehol Gemini 4 Carbon (Fable 51,4 %).
In early testing on FrontierCode 2.0, Fable 5.2 at High effort scored about level with Opus 5.5 at Max effort, for roughly half the cost per task. At Xhigh effort, it scored the highest of any released model tested.
— Claude (@claudeai) November 9, 2026
Medium is the default in Claude apps and Claude Code. pic.twitter.com/ysqCst6mEV
Dôležitý detail sú takzvané úrovne úsilia, ktorých má Fable päť: Low, Medium, High, Xhigh a Max. Čím vyššia úroveň, tým dlhšie model premýšľa a tým viac stojí. V aplikáciách Claude aj v Claude Code je predvolená úroveň Medium. Podľa Anthropicu na nastavení Low Fable vyrovná najlepšie skóre Opusu 5.5 vo FrontierCode za menej ako desatinu ceny za úlohu.
Čo ukázali nezávislé testy
Benchmarky od výrobcu sú jedna vec, nezávislé merania druhá. Firma Artificial Analysis dala Fable 5.2 v indexe inteligencie 65 bodov, čo je nové prvé miesto. Druhý je Gemini 4 Carbon so 60 bodmi, tretí Claude Opus 5.5 s 59 a GPT-6 Astra má 57. Oproti Fable 5.1 je to skok asi o 15 bodov. Fable vedie v piatich z deviatich testov, najmä vo vedeckom uvažovaní, faktických vedomostiach a programovaní.
Anthropic has released Claude Fable 5.2, taking the #1 spot on the Artificial Analysis Intelligence Index v5 at 65, led by gains in science, knowledge, and coding
— Artificial Analysis (@ArtificialAnlys) November 9, 2026
At max effort it scores 65, 5 points ahead of Gemini 4 Carbon (high, 60) and 6 ahead of Claude Opus 5.5 (max, 59).… pic.twitter.com/iRZUbpDcTW
Artificial Analysis však upozorňuje aj na slabiny. Pri praktickej kancelárskej práci (AA-Briefcase) je Fable len na úrovni Opusu 5.5 a tesne za Claude Sonnet 5.5. V teste Terminal-Bench 4.0 má 60 %, rovnako ako Opus, a predbehli ho Kimi K3.1 Pro, Gemini 4 Carbon aj Sonnet 5.5. A je drahší: jedna úloha z indexu stojí na maximálnom úsilí v priemere 26,5 dolára, teda asi 2,6-krát viac ako pri Opuse 5.5. Na nastaveniach High a Xhigh má však 62 bodov, čo je stále viac než akýkoľvek iný model, a spotrebuje pritom zhruba polovicu tokenov oproti Opusu na maxime.
Podobne zmiešané sú reakcie vývojárov. YouTuber Matthew Berman ho po testoch označil za najlepší model, aký kedy používal, a nechal ho postaviť hrateľný klon hry Gears of War, ktorý stál asi 15 000 dolárov v API poplatkoch, či klon Excelu s kontingenčnými tabuľkami za zhruba 11 700 dolárov a 50 hodín práce. Programátor Theo Browne naopak po 14 hodinách testovania zostal pri Opuse 5.5 ako pri hlavnom modeli. Pri analýze reálneho kódu mu Fable urobil 4 nepravdivé tvrdenia z 61, kým Sonnet 5.5 žiadne, a rovnaký test stál s Fable asi 23 dolárov oproti 4,19 dolára so Sonnetom. Na Hacker News sa ľudia sťažovali aj na to, že Fable pri veľkých úlohách spúšťa priveľa pomocných agentov a rýchlo minie rozpočet.
Na čo ho ľudia reálne používajú
Fable 5.2 nie je model na rýchlu otázku do chatu. Jeho silou je, že dostane veľkú, nejasne zadanú úlohu a pracuje na nej samostatne celé hodiny, kým nemá hotový výsledok. Anthropic ukázal niekoľko príkladov z testovania pred vydaním. Z jedného odseku zadania Fable navrhol tri funkčné elektronické zariadenia, medzi nimi hlasového asistenta pre domácnosť. Sám napísal špecifikáciu, vybral súčiastky, navrhol štvorvrstvové dosky plošných spojov, kryty na 3D tlač aj softvér a všetky tri zariadenia fungovali bez úprav.
During pre-release testing, Claude Fable 5.2 and Claude Mythos 5.2 worked on ambitious projects in many different fields. Here are a few.
— Claude (@claudeai) November 9, 2026
From a one-paragraph prompt, Fable 5.2 designed three working electronic devices, including this home voice assistant hub. pic.twitter.com/efOYdhRr7K
Vo vede Fable podľa Anthropicu vyriešil dva otvorené problémy z teoretickej fyziky čiernych dier, pričom jeden výpočet čakal na riešenie 23 rokov. Tím tisícky agentov Fable 5.2 za 30 hodín kompletne previedol dôkaz Veľkej Fermatovej vety do jazyka, ktorý dokáže overiť počítač krok po kroku, kým Opus 5.5 rovnakým postupom zvládol len 26 % za 18 hodín. V knižnici optimalizačných úloh MIPLIB našiel lepšie riešenie ako doterajšie pri 72 z 203 otvorených problémov, napríklad pri rozvrhu 42 vlakov tak, aby v špičke spotrebovali menej elektriny. V chémii zas za asi pol hodiny navrhol postup výroby zložitých molekúl na úrovni začínajúceho doktoranda, tieto postupy však ešte nikto neoveril v laboratóriu. Výsledky z fyziky aj chémie bude ešte potrebné nezávisle preveriť.
Firmy, ktoré model testovali, spomínajú najmä vytrvalosť. Shopify ho prirovnáva k práci so skúseným seniorným inžinierom, Uber chváli, že pracuje, kým úlohu naozaj nedokončí, a nezastaví sa pri prvom rozumne vyzerajúcom medzivýsledku. Tím agentov podľa Anthropicu preprogramoval produkčnú službu z Pythonu do Rustu a tá sa spúšťa asi 26-krát rýchlejšie. A komunita už stihla ukázať 3D model bunky postavený čisto z kódu, origami so skladacím simulátorom či vysvetľovanie na kriedovej tabuli krok za krokom.
A thread of early experiments with Claude Fable 5.2:
— Claude (@claudeai) November 10, 2026
A 3D model of a cell, built entirely from code one organelle at a time. Built by @kevin_t_ngo. pic.twitter.com/3J3JLJZzoD
Cena a dostupnosť
V API stojí Fable 5.2 8 dolárov za milión vstupných a 40 dolárov za milión výstupných tokenov, kým Fable 5.1 stál 10 a 50 dolárov. Čítanie z vyrovnávacej pamäte vyjde na 0,20 dolára za milión tokenov. Voliteľný rýchly režim generuje až 2,5-krát rýchlejšie za dvojnásobnú cenu 16 a 80 dolárov. Model má kontextové okno 1 milión tokenov, rozumie textu aj obrázkom a podľa Anthropicu odpovedá až o 30 % rýchlejšie ako Fable 5.1.
Vyskúšať si ho môžete na všetkých platených plánoch Claude, teda od Pro za 20 dolárov mesačne, ďalej na Claude Platform pod označením claude-fable-5-2 a u veľkých cloudov Amazon Web Services, Google Cloud a Microsoft Azure. V predplatnom však počítajte s tým, že Fable míňa limity rýchlo, na plánoch Pro a štandardných Team miestach môže tvoriť najviac polovicu týždenného limitu. Ako bonus k vydaniu dostanú vybrané plány jedno až tri obnovenia limitu pre Fable podľa dĺžky predplatného.
Mythos 5.2 si bežný používateľ nevyskúša. Organizácie môžu požiadať o prístup cez programy Cyber Verification a Life Sciences Verification, firemní zákazníci ho využijú aj v službe Claude Security na skenovanie kódu. Pre bežných ľudí je dobrou správou, že Fable blokuje asi o 55 % menej otázok ako predchodca, takže by sa malo menej často stávať, že odmietne aj celkom nevinnú požiadavku. Blokované otázky z oblasti kyberbezpečnosti namiesto neho zodpovie starší model Opus 4.8.
Záver: komu sa Fable 5.2 oplatí
Fable 5.2 je dnes podľa dostupných testov najsilnejší model na trhu, ale nie najlacnejší a ani najvhodnejší na všetko. Ak používate Claude na bežnú prácu, texty, analýzy či kratšie programovanie, zostaňte pri Opuse 5.5 alebo Sonnete 5.5 a Fable si nechajte na veľké projekty, pri ktorých má pracovať samostatne celé hodiny. Vývojárom odporúčam skúsiť nastavenie Medium alebo High, ktoré podľa testov ponúka najlepší pomer výkonu a ceny, a maximum si nechať len na úlohy, kde naozaj záleží na každom percente.
Zdroje
- Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2
- Claude na X: oznámenie Fable 5.2 a Mythos 5.2 (vlákno)
- Claude na X: projekty z testovania (vlákno)
- Artificial Analysis na X: nezávislý test Claude Fable 5.2
- Geeky Gadgets: Fable 5.2 coding tests (Matthew Berman)
- BigGo Finance: Fable 5.2 wins the benchmarks, Theo Browne still reaches for Opus 5.5
- TLDR: reakcie z Hacker News